code

2018年5月16日 星期三

Google IO 2018 - .app domain

目的

提高https普及率。
此為全世界第一個open (任何人都可以註冊) TLD (top-level domain) with full HTTPS policy。

此地要分清楚Registry和Registrar的不同。看以下連結:

https://help.one.com/hc/en-us/articles/115005588149-What-is-a-registry-registrar-and-registrant-

Registry: 此TLD的創建者/管理者/經營者,以本例子來說是Google
Registrar: 銷售TLD的經銷商,例如goDaddy

民眾通常不會跟Registry打交道,而是透過Registrar。


Target Users

主要瞄準所有跟app development相關的從業人員。

此外還有行銷上的好處:好記較短的網址,例如momoapp.com可以簡化成 momo.app

HTTPS 好處

1. Authenticity: 公開wifi提供者常會對http網站內容做修改(因為掌握底層傳輸機制),所以失去網站的真實性,常見的非惡意的做法是塞入廣告版面。


2. 新的Browser APIs只限制要使用HTTPS傳輸

3. Chrome URL bar會顯示「不安全」給HTTP網站


4. Android P (9.0) default就要HTTPS connection between App and backend


HSTS (HTTP Strict Transport Security)

這是一個讓server告知browser說所有server content壹定要在HTTPS connection上傳輸。


HSTS可以避免connection被ISP downgrade 導向www server的HTTP content (如果有的話),稱為protocol downgrade attack。

再來就是可以做HSTS preloading,也就是一個browser list記載某些TLDs壹定要用HTTPS connection,即便連第一個request header都還沒看到。

由於.app domain已經加入HSTS preload list,所以使用.app domain的website不用花心力去configure HSTS,或是花幾個月的時間去申請加入HSTS preload list。

此外也可以節省website loading時間,如果已經加入HSTS preload list的話,就不會經歷HTTP redirect到HTTPS content的過程。


結論

加入.app domain的好處:
1. marketing advantages:較短且好記的名稱,例如momoecapp.com => momoec.app
2. .app domain已經被加入HSTS preload list,所以server不用花時間心力去configure HSTS以及申請加入preload list,馬上就可以得到HSTS的好處。


2018年1月15日 星期一

Cloud Computing Infrastructure 3 - storages

Storage types and protocols

從low-level access到high level access看起的話:

1. block storage: data bytes以block為單位儲存在裝置中,硬碟或SSD就是此類。如果直接(非透過網路)連接storage,稱為DAS (direct attached storage)。
block storage的速度會以IOPS (IO operations per sec)來判定。

DAS採用的access protocols包括 SATA/USB/SCSI。
非DAS採用的protocols包括iSCSI (internet SCSI) /SAN (storage area network)。


2. file storage: 人類會以files/folders來理解操作storage。
DAS對應的file-level protocol包括FAT/NTFS
非DAS對應的protocol: NFS/SMB等,這類storage又稱為NAS (network attached storage)。

3. object storage: 這又更高階抽象化的儲存單元,這在cloud applications中特別常見,protocols主要的設計方向就是horizontal scaling,這符合cloud的精神。


DAS Storages in the Cloud

<Storage for virtual servers>
cloud vendor為了達成share resources,會採用block storage,實際上是一個DAS,但對每一個virtual machine來說看到的是"local storage instance"。

雖然block storage擁有最快速的access time,但由於一個storage instance是shared resource虛擬化出來的,所以其儲存時間是暫時性的,一旦virtual server關閉,此shared storage instance也將會被釋放資源,回歸shared pool,使用者必須把data儲存在更為persistent的storage上。

當然如果client使用的是bare metal架構,那要裝幾個DAS都可以,也可以組成RAID。

<Storage for containers and serverless computing>
containers採用的是file storage,虛擬化之後containers看到的也是namespace中的temporary local storage,不過containers之間可以share storage。

serverless computing通常不會有storage (因為這是一種state),不過cloud vendor有可能給予暫時性的storage。


SAN storage in the cloud

當然cloud也可以佈署SAN (storage area networks),這是block storage的protocol。SAN storage可以跟virtual server分開佈署,所以不受限於virtual server的life cycle。

不過每次跟某一個virtual server連接(邏輯上的)時,這個SAN storage就必須要format/partition並且重新mount file systems,所以一次只能跟一個virtual server attach。

SAN storage的IOPS取決於網路的速度。


NAS storage in the cloud

SAN storage要format/partition,當然cloud vendors也可以提供快速mounting的file system,前提就是non-attached。


Object storage in the cloud

object就是non-structured data,俗稱blobs,通常是media/backups 等binary raw data。
blob會友伴隨著meta data,方便search和indexing。

S3 (simple storage service)就是Amazon的object storage implementation。

由於blobs通常檔案size很大(例如照片影像),所以storage consistency通常可以容忍delay,以秒為計算單位,這在internet application (e.g. FB)是可以接受的時間,但不適合需要極度synchronization的applicatoin,例如金融或是安全applications。


CDN (content delivery network)

CDN是比storage更上位的單位,通常是為了加速access而將資訊複製在不同geological的data center中,看資訊型態而言,通常會以object storage的方式在低階儲存,因為CDN通常是serve media。


2018年1月8日 星期一

Cloud Computing Infrastructure 2 - virtual server introduction

Virtual Server

virtual server就是hypervisor software創造出來的虛擬的邏輯運算單元,彷彿一個真的獨立運行的機器,在其上可以安裝不同的OS,即便完全跟host machine的OS不同也沒關係。

有兩種架構:


第一種是bare metal,hypervisor軟體直接跑在硬體上,另一種是hosted,hypervisor軟體仍然跑在host machine的OS之上。

資源如何分享呢? host machine上的CPU通常是多核心的,每個核心當然又可以跑多執行緒,而hypervisor軟體利用intel的hyperthreading技術,把每個thread可以視為一個"virtual cpu",所以這樣所有的virtual server都有了運算資源,當然記憶體和storage的虛擬化分享也可以類似泡製。

每個host machine也配備多個網路卡介面(NICs),所以virtual servers也能有獨立的網路資源。


Auto scaling

virtual server可以依照客戶使用量做自動的資源增減。
由於virtual server是虛擬的單元,這樣的scaling是橫向的,也就是需要的時候就多開幾個virtual servers,而不是去縱向置換成硬體能力更強大的server。

橫向的scaling才會沒有限制。

Load balancing

利用一台gateway機器來分配incoming requests給不同的virtual server,避免某幾台virtual server負擔過重。

分配不受地理條件的限制,亦即有可能分配到不同地理區域的host machine上的virtual servers。


Bare metal servers

意思是cloud vendor可以出租整個physical host machine給需要的客戶,也就是非分享的machine,所以不會有"noisy neighbors effect",這讓客戶可以建立off-premises private cloud,有充分的主控權。


Colocation

這算是一種機房配置,客戶可以把自己的私人機器放入cloud vendor的機房內,享有cloud vendor的硬體配置與安全保護,但又有自己的私人機器安全性與隱私。

舉例來說,安裝一個colocation的gateway來連接on-premises與off-premises 的hybrid cloud。


Containers

containers跑在OS上面,一個container image封裝了需要執行某個application所需要的一切runtime libraries,而且被高度的isolated,只看到自己的namespace下的file system (in memory)。

有名的container management software為Docker。

containers和virtual server的異同:


container算是sandboxes,可以快速deploy,不像provision virtual server那樣花費時間,但也由於share同一個host OS,這也樣containers受限了,也就是一台機器上不能有不同OS 的application sandboxes。

containers適合用來開發micro services,因為不同的micro services之間的開發時間和流程不一樣,用containers來deploy就不會影響彼此services之間的版本衝突等。(?! 好像有點牽強,不熟悉這種開發過程)


Server-less computing

這是最lightweight的compute (意思是computation unit),這不用host server / container apps,而是只做request/event handlers,可以稱為Function as a Service, FaaS。

之前在erlang有玩過,因為erlang沒有state,沒有mutables,所以在語法層面可以支援stateless server,也就是server-less。

AWS的implementation為 AWS Lambda。

Cloud Computing Infrastructure 1 - cloud service model overview

Cloud computing實現的背後技術

1. virtualization: 透過hypervisor software來把資源邏輯化切割成可以量化, on-demand的資源。

2. internet: 任何地方都可以存取

Cloud services models

綜觀如下:


on-premises意思是公司有機房自己host infrastructure,從左到右公司需要維護的infrastructure越來越少,當然掌控程度也越來越低。

Cloud Deployment Models

public cloud: 跟所有人share virtualized resources,資源使用性可能會被其他使用者影響到(noisy neighbor effect)。

private cloud: 不跟任何人share virtualized resources,可以自建機房(on-premises),或是託管 (off-premises)。也可以自己安裝與掌控virtualization software,例如OpenStack, VMWare vCenter。

Hybrid cloud: 以上兩種的混合,可以把適合的application放上public cloud。


2018年1月4日 星期四

iOS testing 3 - XCode 9 new testing features

這是WWDC 2017 #409 "What's new in testing" 筆記。

New Async waiting API

通常會用到async API的情況如下:


之前Xcode6 我們需要這樣做async waiting:


上面程式要開啟遠端某個文件, 在實際上開啟之前(document.open()),我們先定義一個expectation,然後為此async operation設定expectation,當此operation真的完成的話,在success closure裡面我們就要關閉或說fulfill 這個expectation。

限制如下:
1. timeout會被判定成failure
2. waiting (e.g. waitForExpectations()) 是XCUITest instance method,綁死了
3. 沒有nested waiting


XCTWaiter
這是針對上面限制的改良,主要是把waiting從XCUITest分離出來:


timeout的處理方式提供了delegate或是 closure,或是XCTWaiter intance,更加彈性了。

另外記得去看XCTestExpectation的new features。

Multiple App UI Testing

現在可以在不同的target app間測試互動情況,有需要再研究。


不知道可不可以launch 3rd party來測試?

Performance of UI Testing

要找到畫面中的一個ui element,我們必須去做query。XCUIQuery是需要用到accessibility data,舊的做法是test app藉由interprocess communication,去要某個時間點target app的serialized "snapshot",就是app state snapshot:


這個做法在state相當龐大的時候(例如app使用超多記憶體),會有testing performance impact,甚至會造成某些testing timeout,使得test case被誤判成failure。更極端有可能因為query使用太多記憶體而process被killed。

要到snapshot,判別query的責任是落在test app身上。


xcode9的做法是:
(1) remote query: 減少interprocess data


現在改成只傳query data給target app,然後query在target app身上做(那還不是會造成target app performance impact?!),最後再把query results傳回給testing app。

所以這樣能夠減少testing app負擔,以及減少interprocess communication,這得到30%的記憶體與速度改善:


(2) query analysis: 透過分析來減少一個query要實現需要的最小的app states snapshot,這樣當然也可以減少運算時間與memory。


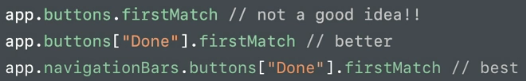
(3) programmer tools: 透過programmer對不同測試情境的知識,可以決定是何時可以做較短的query,提供"firstMatch"這類method讓query不用走完整個query data hierarchy。


firstMatch是改善最多的,但這是需要programmer對ui layout的了解才有辦法達成!

一個原則就是,你query的越精確,越會有好的testing performance,所以這樣也同樣無法依賴所謂的UI Recording,基本上是個廢物說實在的:


新架構避免使用的寫法

不要用block(closure) based NSPredicate,因為block不能被serialized,也不能在runtime被optimize:


上面說道的optimization都不能用了,所以避免使用block based NSPredicate 。


更好的test report: Activities / Attachments / Screen shots

activity是把一堆test command group起來,變成一個存活較久的test:


這個好處是讓test report看起來很簡潔,也比較有表達性:


XCode 9提供了screenshot api,可以讓XCUIElement或是整個screen都擷取快照圖片。
attachment則是讓test report把一些(包括screen shots) 想要跟activity 一起呈現在test report中的data包裹起來:


所以在test report中就會看到activity包含了attachments (此例中是screenshots):


動工吧!!!!

2017年12月23日 星期六

iOS Universal Links and Android App Links

Android App Links

我們可以把app中的content透過連結,讓使用者直接開啟app到那個特定的content,有以下兩種連結方方法可以做到:

Deep Links: 這是使用URL的方法,我們必須在app中加入intent filters,然後解析intent帶來的data來開啟相對應的activity。潛在問題是其他的app如果也listen相同的intent,則可以獲取此連結開啟權力。

Android App Links (Android 6.0+ / api 23+): 設定一個app為某種link的default handler,使用者可以在Android系統設定中更改此設定。好處包括:
  • 需驗證HTTP URL domain ownership,不會被其他app冒用
  • 如果使用者沒安裝app的話,會直接導向web
  • support Instant Apps (不用安裝app就可以使用app)
  • 可以從以下地方導到app content:
    • mobile browser中點擊Google search結果
    • Google Search app
    • Android screen search
    • Google Assistant
可以說App Links是強化版本的URL scheme deep links。怎麼實現App Links呢?

簡單來說:
1. 放一個json file到一個https的網站,讓Android用來驗證網站所有權以及app關聯性。
2. 在app manifest宣告某個activity相關的intent filter,以及要設定autoVerify為true,這樣Android才會在launch activity的第一次就驗證關聯性。

很簡單,困難點反而是在怎麼建立一個https網站,如果對我這種backend白癡來說的話。

iOS Universal Links

iOS Universal Links跟Android App Links就是一樣的東西,行為:
  • 如果有安裝app,則點擊網頁中的link會開啟app中的某個特定畫面
  • 如果沒安裝app則開啟Safari導到這個link連結的網頁
  • 不會被開啟其他宣稱能handle此url的app (同樣經過網站所有權驗證)
  • 不過如果原本已經開啟此domain web page,就不會開啟app
所有權認證的方式跟App Links一樣,放一個json file在某個static path下面,大概長這樣:


上面9JA89QQLNQ是team id,可以在developer portal找到,後面接的就是app id,整個構起一個identify這個app的key, value是一個array (paths),標明哪些path可以由app來handle,如果整個網站都在app有對應的handler,那就像上面黃色字樣寫的"*"。

或是部分被app handle的話:


結論

這兩個平台提供的Dee[ Link方法對server端幾乎沒有影響,設計很好!


2017年12月11日 星期一

Software Security 2 - Buffer Overflow attack

Low-level Security: Buffer Overflow (stack smashing)

這主要發生在C/C++,目前常使用的系統包括: OS kernels, servers (各種http server, memory cache等), embedded systems。

定義: access 一個buffer非合法的index範圍,就是一個buffer overflow attack。


Process 記憶體配置複習

首先一個program要執行時,會有一個process執行它,這個process被分配了某個大小的記憶體,例如在32bit系統上,記憶體位址為 0 ~ 2^32 - 1:


這記憶體位址當然是虛擬(logical address)的,不是真實的physical address (那什麼叫做physical address?),只對此process來說有意義,這個記憶體區塊又分為以下的堆疊:


Text就是code (e.g. function implementation),Heap被malloc管理,而Stack存放local variables和function calls,把Stack和Heap放置呈水平來看:


每當Stack push一個local variable,它會往memory address較低的方向push,而heap剛好相反,每當allocate一個新的memory,heap會往address較高的方向增加。

Compiler在runtime會透過指令去調整stack所占記憶體的大小(push / pop / return),malloc implementation則負責管理跟OS要(allocate)的記憶體,但是要到的記憶體則充分由malloc管理。


Stack and Function calls

假設有一個function有三個傳進來的參數,以及兩個local variables,定義如下:


當一個function的caller呼叫此function時,compiler會先把帶進的參數以相反順序push到stack上,而local variables "通常" 會以宣告的順序push到stack上:


那program要怎麼知道loc2在記憶體中的位置呢? 絕對位置無法得知,因為這個function可能被call很多次,每次呼叫都會push一個loc2到stack上,但是compiler可以知道相對於caller的位置。

先定義stack frame為每次此function被呼叫時使用到的stack範圍:


compiler使用一個稱為 frame pointer (i.e. ebp register),這指向了一個funciton的local variable的起始記憶體位置:

所以在32bit word機器上,loc2 address = %ebp - 2words = %ebp - 8 bytes


假設main()呼叫了func(),首先對compiler來說,main()跟func()沒什麼兩樣,所以先把main的parameters/local variables push到stack上面,就是上圖中的caller's data部分,當然對main()來說,它有儲存自己的frame pointer到ebp register (下圖綠色字眼):


compiler把func()的arg3, arg2, arg1 push到stack上,然後得要在ebp register中記錄func()的frame pointer (i.e. func()的local variable起始位置),可是這樣在func() return之後, 我們ebp register仍然保有的是func()的frame pointer,而不是main()的,這樣main()的接下來未執行的程式就無法找到main()的local variable相對位置,所以我們必須要把這個main()的 frame pointer也push到stack 上:


所以第一個問號就是caller (main())的frame pointer,這樣我們等一下可以直接用這個pointer指向的位置來restore ebp register成caller的frame pointer。

我們還需要push第二個問號: 目前的instruction pointer。
由於func()在text (code)的位置當然不同於main()的位置,所以呼叫func()代表instruction pointer要jump到不同的位置:


所以從func() return 回來的時候,我們不但restore了main()的frame pointer到ebp register,也restore了jump 之前的 instruction pointer到 eip register,這樣就完成了一個function call。


Buffer Overflow

以下這段程式碼,被strcpy造成了buffer overflow (i.e. access 不該access的address):


首先main()呼叫了func(),所以compiler執行過後的stack會長這樣:

strcpy會造成overflow,所以原本記錄著main()的frame pointer變成了:


所以當func() returns,這個錯誤的frame pointer會被複寫到ebp register,造成segmentation fault:


可是如果overflow複寫的不是ebp register,而是另一個local variable?


如果上面的authenticated是一個安全檢查的local variable,則這個buffer overflow造成了檢查漏洞:


Code Injection

buffer overflow既然有可能改寫contiguous memory上面的數值,且可以直接複寫不論多少bytes都可以,所以hacker面臨兩個主要挑戰:

1. 怎麼把自己的惡意的assembly code塞到memory?
2. 怎麼移動instruction pointer指到自已惡意的code來執行?

關於第一點,由於strcpy / sprintf 等有可能造成buffer overflow的function都會在遇到 '\0' byte的時候就停止operation,所以hacker要先避免自己的assembly code有NULL byte。另外當然自己的assembly code必須是完整的,不依賴loader去load其他位置的code。

這個injected code最好是能執行shell command,稱為shellcode,例如以下:

最後一行就是執行了shell command,也就是執行了 "bin/sh"。


再來關於第二點,怎麼移動instruction pointer到自己的code?
還記得呼叫一個funciton的時候,stack frame會長這樣:

所以我們只要把儲存caller instruction pointer的memory (上圖中的 藍色%eip位置),改寫成惡意code的起始位置0xbff即可。問題是我們怎麼知道我們惡意的code是在memory中的哪個位置?

推理,precondition:
(a) hacker不知道原本的source code,所以hacker不知道buffer的記憶體位置以及大小,所以無法知道自己透過overflow inject的code在記憶體的位置

(b) hacker可以access目前eip和ebp register,所以她知道目前這個callee的frame pointer是指向哪裡,所以可以知道存放caller的instruction pointer存放在哪個記憶體位置。

(b) 如果caller的instruction pointer填錯位置(亂猜)的話,則CPU jump後會看到invalid instruction,就panic當機。所以在惡意的code之前塞入一堆noop instruction,這是1-byte instruction,CPU看到這個只會停止一個cycle不做事,不會panic,所以可以提高亂猜卻抵達injected code機率:


所以要使得惡意inject code能被執行就是靠 "猜"一個可能的位置,存放在caller instruction pointer存放的位置,這在function return的時候會jump過去,然而由於是猜測的位置,所以要靠多放一些noops在惡意的code之前來提高jump過後不會panic的機率。

大致上是這樣:


Software Security 1 - Introduction

Computer Security

定義軟體 "不該發生什麼行為"

  • 不該違反保密協定 (confidentiality)
  • 不該違反功能完整性 (integrity)
  • 不該違反存取性 (accessibility)


Hacker exploits "Defects"

flaw是系統設計面的瑕疵,意思是software有超出requirement定義的行為。

bug是系統實作面的錯誤。

defects: hackers利用flaws / bugs 來攻擊的漏洞,defects會被hackers利用來侵入系統,這叫做脆弱性 (vulnerability),所以即便bug可能看起來無關緊要,但很有可能給予hackers攻擊的漏洞或是靈感。


Software Security

是focus在code層次 安全性的學問。


OS Security

使用到OS system calls都能受到OS層級的安全性保護,例如Alice不能access Bob的folder,或是如果沒開放port 80,則不可能有人能從port 80連出或連進來。

但是OS security涵蓋不瞭Application 內部的安全細節,例如只有database software能分辨與執行機敏性資料的存取政策,OS是幫不上忙的(也不該)。

此外,OS不能貫徹information flow policies,稍後會說明。


Firewalls and Intrusion Detection System (IDSs)

防火牆主要是用來過濾可以存取資料的連線,主要利用hosts / ip / ports 等protocol定義內容來過濾。

侵入偵測系統IDS則是會分析封包內容,找出符合可能風險模式的封包,予以阻擋。

防火牆允許的port不一定是它預設要保護的service,例如port 80不一定是執行http server,例如SOAP是利用http protocol來交換message的一種協定,但這邊就做了很多http server做不到的事,所以防火牆如果假設port 80只會是http server (通常都是)那就可能形成一個可以exploit的入口。

IDS也是能有被降低分析能力的攻擊方法。


Anti-virus Scanners

這是local端的IDS,但也有可能因為performance考量而犧牲了偵測能力。


2017年12月6日 星期三

Keychain & TouchID 整合

Keychain

keychain是一個database,每個key-value pairs稱為一個keychain item,所有的values都加密過,特別適合用來儲藏小size的user secrets。

Keychain需要link ios Security.framework,我們的application透過SecItem API來存取keychain items:


app process透過SecItem API把我們的request丟給另一個process "securityd",這算是一個中間人,因為他雖然可以query Keychain database,但是並沒有decrypt keychain value的能力,所以"securityd"會再把這個encrypted value丟到Apple A7+ chip上面的硬體security code processor稱為 Secure enclave,由此module決定是否要decrypt。

Keychain安全性

1. 被使用者iphone密碼保護
2. 被使用者iphone 出廠設定的unique device secret保護
3. keychain只有當使用者解鎖之後才能access
4. access control (只有儲存data的app能access自己的data)

總之Keychain是Apple保護某個on disk的secrets的功能,我們可以確信此protection是安全的,但是我們application的責任就是:不能把解密過後的secrets長期放到memory中(e.g. global/static variables),或是透過網路傳送。


SecItem APIs

SecItem是C API:


Data protection classes

Keychain裡面的item能否被access,藉由設定以下幾種可能的protection profiles給kSecAttrAccessible attribute:


包括以下幾種(詳見api document說明):


但是以上幾種不能確定使用者到底有沒有設定device passcode,除非使用以下:


上面這個protection class 是說keychain只有當user authenticate之後才能access,而且當user lock device之後就不能access。當passcode被移除的話,在Secure enclave上的passcode secret就會被移除,所以再也無法解密被保護的items。


Keychain Access Control List (ACL)

每當app要access被ACL和touch id保護的keychain item的時候,以下這個畫面就會跳出來:


輸入device passcode標準介面:


ACL定義:
1. authentication,藉由policy control:


2. item accessibility


Touch ID Authentication

touch ID可以用來當作authenticate,用來驗證可否存取keychain裡面的item,安全性來自Secure enclave,所有的touch id data都存放在secure enclave中,而且所有的touch id operations都在secure enclave中完成,即便OS kernel被compromised也不影響其安全性,因為是一個sandbox。

Secure enclave如果發現touch id數次驗證未過的話,就會強制只能透過device passcode authenticate,重新輸入device passcode之後就能恢復使用touch id authentication。

注意keychain key operations也是在secure enclave中完成,所以跟touch id搭配是非常適合的。

使用ACL來進行touch id authentication是由LocalAuthentication framework提供API來讓application使用:


Code Example

儲存secrets: 原本沒有ACL control的keychain storage如下


如果我們加上ACL control:


讀取secrets


SecItemCopyMatching會啟動LocalAuthentication 功能,所以系統的指紋辨試或是passcode輸入畫面就會出現。不過為了不要block main thread,這個SecItemCopyMatching最好是放到global queue中。