code

2017年10月19日 星期四

Stanford ios 10 with Swift 筆記2 - Swift 1

Optional只是一個enum


some case的type T 就是associated value的type。
所以以下兩者是相同的宣告:


所以用unwrap !符號等於是對enum的switch case,如果是some(T) instance的話,就回傳unpacked associated value,否則raise exception。


但是如果是用if let 來嘗試unwrap的話,邏輯如同以下的enum switch case:


所以是安全的,y頂多就還是nil,不會raise exception。

跟kotlin不一樣,比較有趣的是可以用個1-liner來設定default value:


Tuples

這樣宣告:


Range

range是一個struct,type T必須要comparable:


inclusive or exclusive:

所以以上也是array slicing的方式。

Range<Int>是一個CountableRange,所以可以被enumerate。


Value vs Reference

class instance (object)是referenced type,也就是利用pointer去access,而struct/enum是value type,也就是每次pass都是一份copy。Swift prefer functional programming,所以建議都用struct / enum。

FP approach更適合做testing,因為就是input -> output,沒有side effect。


Static methods

Swift也有type (class / struct) method,也用static keyword:


Properties

observer: swift能對property (就是instance variable)做computed property,也能做observer:


lazy: 也有lazy initialization pattern,所有的class property都需要被init才能使用,但如果這個property要在initialization階段呼叫自己的methods,那是不可能compile的。不過如果用上lazy就可以:


Array

Array是generic type,所以要宣告時要加上Array<Type>()。Array也是一個sequence,所以可以用for .. in 的語法去enumerate。

當然swift sequence也有FP的filter / map:


Dictionary

比較特別的是,利用key index出value,回傳是一個optional,這可以用let來safe unwrap:


String

要取出string中的某個index的character,可以用 s[String.Index],所以index不是int type,而是String.Index type,這邊要注意一下。


但以上不是slicing 的好方法。

String有一個property,是一個sequence可以用來enumerate。


Initialization

struct default對所有properties做init (所以有一個default constructor),但是如果真的給了一個initializer,則default init就沒了。

class只有未繼承他人者才有default init。init function就是某一個constructor。
很複雜,盡量不要用到classes in Swift XD


Any / AnyObject

AnyObject是為了相容objectiveC,所以沒啥好講的。
Any可以算是...就是any ,但是必須要convert成Optional:


2017年10月18日 星期三

Fabric for Android

Modular kits

fabric有很多modular kits,類似plugin或是packages可以安裝。

Crashlytics Kit

這是fabric的crash reporting solution,提供real-time analytics,建議透過Crashlytics來安裝Answers kit。


Answers Kit

這是fabric的核心引擎,提供real-time analytics,建議透過Crashlytics來安裝Answers kit,安裝了Answers之後就會有以下這些東西:

Top-level metrics
1. active users: 五分鐘內正在使用的使用者
2. daily active users: 某天內的使用者
3. daily new users
4. monthly active users: 最後30天內的使用者
5. cash-free users: DAU中沒有crash的佔比
6. sessions: 一天中所有版本的app使用的session數目,session定義為一個foreground -> background event,並且在背景中至少30秒

Answers Kit Twitter Integration:  Answers能使用twitter的audience insight。

Answers Kit Event Tracking:  使用者可以track最多3000個不同的event,每個event都沒有log數量的上限,每個event可以有最多20個custom events。

Android Studio Plugin

可以search "fabric for android"在Android Studio的preference中安裝。
很白痴的是,plugin介面中沒有提供切換帳號的按鈕,要記住快速鍵 ctrl - L來登出。


Agile Software Development 1 - 概觀

Agile Manifesto

agile原始方法論一開始是幾個software consultants提出,他們當初的12原則如下:


這在2000年初提出來的,現在看來真的很先進的工作理念,因為隱含著尊重個體,顧客為主,擁抱變化,以及持續改進等四大軟體工作管理模式,現在當然稀鬆平常(但是真的implement的台灣公司很少),當初應該是創舉。


Agile Methods

1. XP: 主要貢獻是把標準軟體製造重點從documentation / SOP 轉換到software以及programmer本身,也就是software才是真正衡量成就的標準,而不是完美的UML 或是符合CMMI (稱為process-oriented methods)。

2.  Lean: 借鏡Toyota管理車廠方式,引用到software engineering來,主要focus在如何消除浪費,其中浪費包括無意義的documentation,要把焦點放在如何deliver software到客戶手中。

3. Crystal:嘗試結合agile與傳統process-oriented methods。

4. Scrum: 這是本課程重點,也是近年agilist的主要信念,這其實不一定專門應用在軟體開發上。通常近年來我們說到"agile",事實上幾乎都是指"Scrum",是一種project management的principle。


Agile Values (vision)

1. 縮減manager權力,不該由manager去assign tasks! 這statement很神奇,期待後面的解說。
2. 邊做邊設計,而非一開始花一堆時間設計和架構
3. 縮短的iteration驗證
4. 只做對顧客馬上有用的事 (Lean屏除waste的概念)
5. 專注在品質上,利用充分測試達成


Deep Learning 筆記1 - 什麼是Deep Learning?

什麼是Neural Networks?

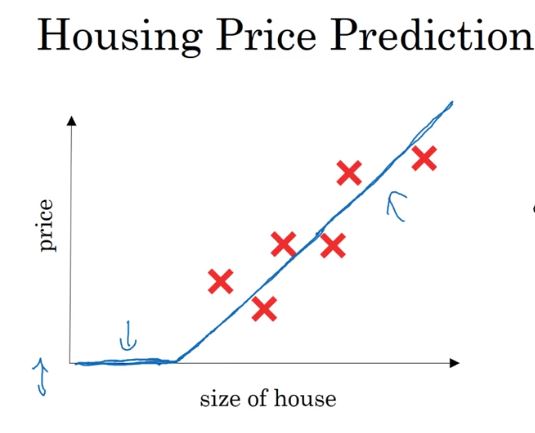
假設有以下的data,我們如果用某個function來fit這個dataset (例如linear regression),這個function可以說就是一個最簡單的neural network (事實上這個藍色的線代表的function叫做rectified linear unit, ReLu):


我們把size資訊丟進去一個neuron,最後吐出一個price prediction:


所以neuron代表的就是一個function。

如果考慮更多input feature的話,一個較大型的neural network就會出現了:


我們在training的時候只要提供input x和label y,中間的features或weights演算法會幫我們完成。我們要implement的neural network事實上是每個中間layer (hidden layer)的node都連接所有的input value:


Applications


Structured Data vs Unstructured Data

structured data就是某些數字量化的,跟要預測事務有相關性的data,例如年齡, 價錢, ...


Unstructured data通常是某個整體性instance的呈現,例如一張圖的pixels,或是一段錄音檔的震幅,或是一篇文字,這樣的raw data還不知道如何抽出量化的資訊者 (patterns):


為何Neural networks近年來快速發展?
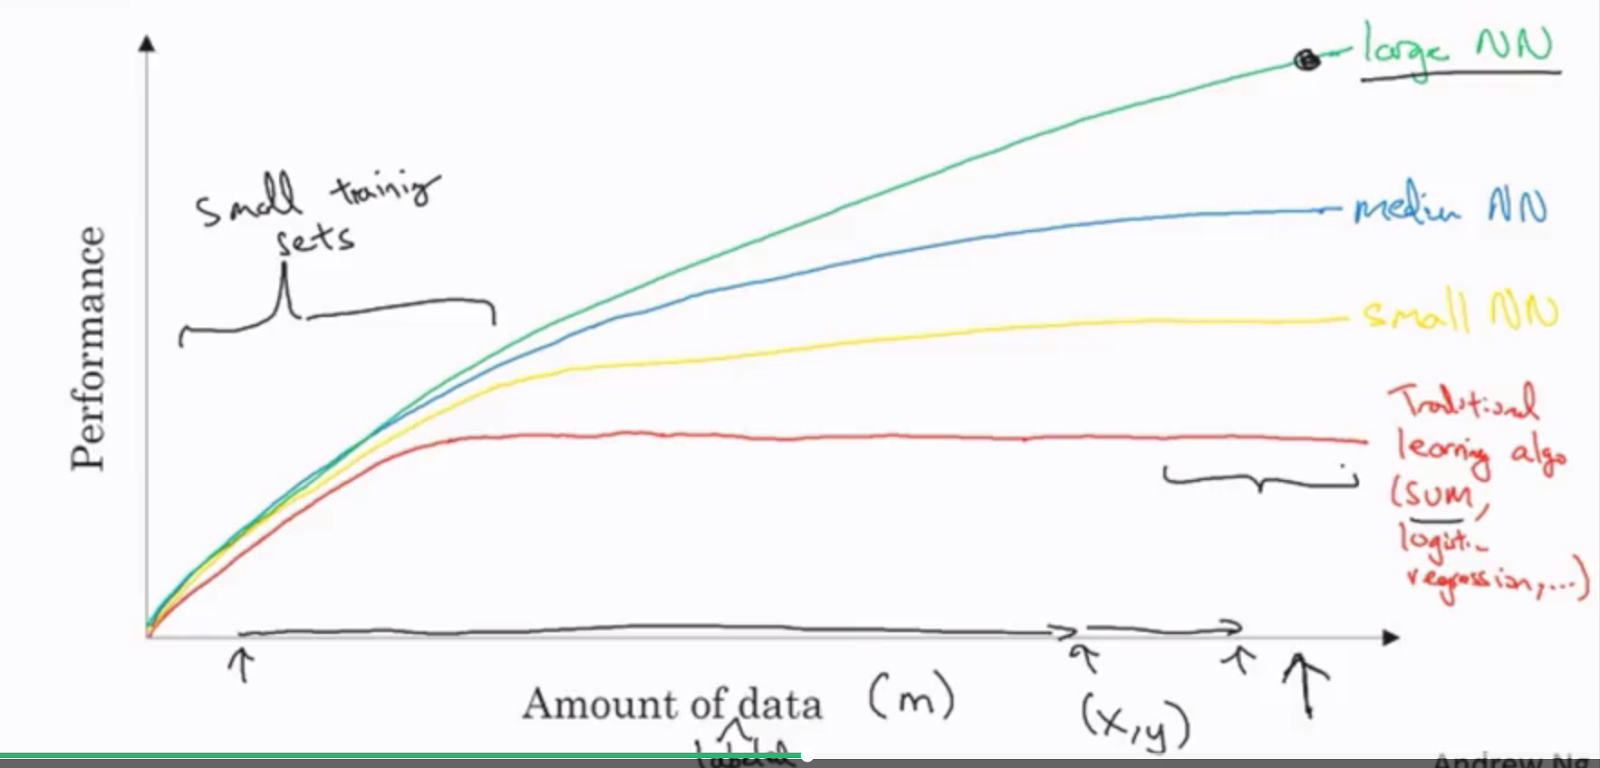
由於data變多了,以及有更好演算法能力train更大型的NN,兩者都是NN會比傳統ML例如svm / logistic regression好的原因:


由上圖可以看出,當x軸 (m = number of training data)增加時,傳統ML方法(紅線)並無法提升performance,而NN可以exploit big data,而且performance隨著NN的scale成長。但是在small data領域,則傳統ML不輸給NN,所以取決於feature engineering等技巧。

另一個推進NN的動力是硬體計算能力大幅提升,因為training NN是一個iterative action:


train的越快,越能改進NN。


2017年10月16日 星期一

Stanford ios 10 with Swift 筆記1 - Constraints

如何把製作autolayout?

portrait時候長這樣是ok的:

但是landscape就掛點了:


這邊要做的步驟邏輯如下:
1. 把每一個row的按鈕都group (或稱stack horizontally)起來:


或是用右下角的快速按鈕:


用property panel調整spacing和大小:


2. 把每個group再group一次(或稱stack vertically)


3. 利用property panel調整此stack的alignment成fill,以及spacing成10:


4. 對顯示數字條也做vertical stacking:


注意數字鍵跟數字顯示條stack一起,distribution和alignment就是這兩個item在作用,用這樣的想法就不會覺得行為超出理解。


5. 設定top / head (left) / trailing (right) / bottom space,按住crtl從stack拉向上下左右四個邊際:


當然這四個距離要設成零,double-click在這四條線上設定就可以。這事實上是加入了一些constraints:


最後再調整一下數字鍵的stack成distribution equally:

可以看到即便是landscape mode也是ok的:

2017年10月8日 星期日

Caltech Learning from Data 4 - error and noise

point-wise error measurement

我們要知道hypothesis跟target f的差別到底多少?
所以會有一個error function E(h,f),嘗試找出h 來 minimize這個function。

每個input點x都會有一個error function:


可能的例子包括之前講過的squared error:


上面的binary error的notation要講一下,意思就是當[ predicate ] predicate為真的時候,回傳1,反之回傳0。所以h(x)與f(x)的分類一致的話, h(x) != f(x)是false,則 [h(x)!=f(x)] 回傳0,這是我們要的,因為這的確就是最小的error分數。


Overall error

定義為 average(all point-wise error),其實就是之前提到過的in-sample error:


也就是training set的training error。
注意所有in-sample points都來自同一個probability distribution (即便未知,但這是符合Hoeffding Inequality的重要前提),但是我們隨機挑選出training set / test set,這是一個uniform distribution,所以會有上面1/N的weights。

out-of-sample error就是h generalization的能力的好壞,此時的x是out-of-sample,也就是test set或是任何x in sample space:


注意這邊average的定義為expectation,因為任何我們不知道underlying distribution為何。

我們又可以完善我們的learning diagram:


如何挑選error  measurement function?

大哉問!沒有正確答案,因為這是domain-specific decision。
先說有以下兩種error:


對某些application來說,false reject (false negative)是很嚴重的事情,例如一個會員怎麼嘗試都無法通過指紋辨識,那肯定會流失客源,不過在此例中,false accept (false positive)就沒那麼嚴重,而且真的被判斷false accept(假設會員優惠)也留下了指紋,對這些利用系統誤判獲得小便宜的人來說,反而留下了證據。

上面這個matrix是一個 penalize weighting matrix,所以如果我們要penalize false reject,可能的matrix:


同樣的指紋classifier,安全門禁系統反而會不在意false reject (false negative),反正刷不過就打電話給MIS人員,但是不能錯放一個外人進入公司重地,也就是要penalize false accept (false positive):


所以完全是domain specific來選擇error function。
繼續來擴充我們的learning diagram:


Noisy targets

一個真實的情況是 target function通常不是一個function (不符合function定義,例如兩個input space的點x1 x2,因為採取了有限的features,使得兩個不同的點卻有相同的input vector x,但是實際上兩者在data中的y卻可能不一樣,例如兩個同樣人種年紀職業的信用卡客戶,一個y1=違約,一個y2=未違約,這是有可能的。

所以同樣一組f(x)卻map到y1和y2,並不符合function的定義,這是由於feature資訊不足造成的,所以真正的y應該是f(x) + 資訊不足造成的noise。 

修正target function成 "target probability distribution" P(y|x),所以y的機率會隨著不同x而update,則(x,y)出現的機率是一個joint probability:


採用y是conditionally dependent on x的機率觀點的話,我們要找的真正的target function f(x)可以視為 E(y|x) + y值跟f(x)的差距(可以歸類成noise):


講這麼多是因為真實案例中的single data point無法真正反映input space的一個點所有資訊,所以 y != f(x),我們只能從(x,y) infer出已經被noise污染過的f(x),也就是來自target distribution P(y|x):


而我們learning只能找出target distribution,永遠不可能找出真正的f(x)。
這是supervised learning最終定案的diagram。


Machine Learning is feasible (以機率觀點來說)

理論面上,首先利用in-sample X 都來自同一個distribution的基礎上,Hoeffding's Inequality提供我們可以透過 in-sample performance (error) 來 track out-of-sample performance的理論可行性,所以機器學習就是建築在一個generalization的論述:


實務上,我們希望Eout(g) ~= 0 (實務上application-specific requirement),這樣代表g ~= f,也就是generalization well,或說"learn well"。